

Implementing Data Preprocessing Handling Missing Data Efficient Data Preparation Make Information




Try Before you Buy Download Free Sample Product
 Impress Your
Audience
 100%
Editable
 Save Hours
of Time


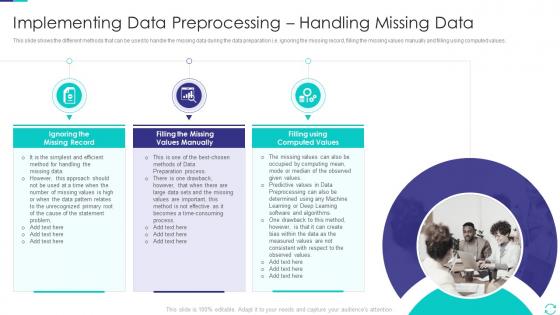
This slide shows the different methods that can be used to handle the missing data during the data preparation i.e. ignoring the missing record, filling the missing values manually and filling using computed values.
People who downloaded this PowerPoint presentation also viewed the following :
Implementing Data Preprocessing Handling Missing Data Efficient Data Preparation Make Information with all 6 slides:
Use our Implementing Data Preprocessing Handling Missing Data Efficient Data Preparation Make Information to effectively help you save your valuable time. They are readymade to fit into any presentation structure.






FAQs for Implementing Data Preprocessing Handling Missing Data Efficient Data
Key data preprocessing steps include data collection, cleaning, transformation, normalization, feature selection, and validation to ensure quality datasets for analysis. These processes streamline machine learning workflows by removing inconsistencies, handling missing values, and optimizing data formats, with many organizations finding that structured preprocessing ultimately delivers faster model training, improved accuracy, and more reliable business insights.
Data cleaning significantly enhances dataset quality by removing inconsistencies, correcting errors, handling missing values, eliminating duplicates, and standardizing formats. Through systematic preprocessing, organizations in healthcare, finance, and retail can reduce analysis errors by up to 80%, improve model accuracy, and ensure reliable insights, ultimately delivering more trustworthy business intelligence and competitive analytical advantages.
Common techniques for handling missing data include deletion methods, imputation strategies, interpolation, forward/backward filling, and multiple imputation approaches. These methods enhance data quality by replacing gaps with statistical estimates, leveraging temporal patterns, or using advanced algorithms, ultimately enabling more accurate analytics and reliable insights for business decision-making across organizations.
Outlier detection improves model performance by preventing skewed training data, reducing noise that distorts patterns, and enhancing prediction accuracy across normal data ranges. Financial institutions and healthcare organizations find that removing anomalous transactions or patient readings enables models to better identify genuine fraud patterns and medical conditions, ultimately delivering more reliable automated decision-making and improved operational efficiency.
Data normalization is crucial because machine learning algorithms often struggle with features at different scales, leading to biased results, slower convergence, and poor performance. By standardizing data ranges, normalization ensures fair feature contribution, accelerates training processes, and improves model accuracy, with financial institutions and healthcare organizations finding that normalized datasets deliver significantly more reliable predictions and faster deployment timelines.
Feature selection identifies and retains the most relevant existing features while removing irrelevant ones, whereas dimensionality reduction creates new transformed features by combining original variables. Feature selection maintains interpretability for applications like fraud detection in banking, while dimensionality reduction streamlines complex datasets in genomics and image processing, ultimately delivering computational efficiency and enhanced model performance across industries.
Data transformation converts raw data into suitable formats for analysis through normalization, encoding categorical variables, scaling numerical features, handling missing values, and creating derived variables. These processes enable algorithms to function effectively, improve model accuracy, and ensure consistent data interpretation across different systems, with many organizations finding that proper transformation significantly reduces analysis time while delivering more reliable insights and competitive advantages.
Encoding categorical variables improves model interpretability by converting text-based categories into numerical formats that algorithms can process, while preserving meaningful relationships between different category levels. Through techniques like one-hot encoding or label encoding, data scientists can clearly trace how specific categorical values influence model predictions, ultimately enabling better decision-making and more transparent AI systems across industries.
Feature scaling significantly impacts distance-based algorithms by ensuring all features contribute equally to distance calculations, preventing variables with larger scales from dominating the results. Without scaling, algorithms like k-means clustering, k-nearest neighbors, and support vector machines can produce skewed outcomes, with financial institutions and healthcare organizations finding that proper normalization enhances model accuracy and delivers more reliable predictive insights.
**INPUT**: How do you assess the quality of a dataset after preprocessing? **OUTPUT**: Assessing dataset quality after preprocessing involves evaluating completeness, consistency, accuracy, and distribution balance through statistical analysis, visualization techniques, and validation checks. Data scientists in sectors like healthcare, finance, and retail use quality metrics, outlier detection, and cross-validation methods to ensure datasets deliver reliable model performance and actionable insights. [Word count: 52 words]
Time series data preprocessing becomes essential when dealing with irregular sampling intervals, missing values, seasonal variations, trend anomalies, and noise interference that can skew analytical results. These techniques prove particularly valuable in financial forecasting, supply chain management, and IoT sensor monitoring, where organizations streamline data quality, enhance predictive accuracy, and ultimately deliver more reliable business insights for strategic decision-making.
Automating data preprocessing involves implementing pipelines with tools like Apache Airflow, Kubeflow, or cloud platforms that handle cleaning, transformation, feature engineering, and validation automatically. These systems streamline workflows by scheduling tasks, monitoring data quality, and ensuring consistency across datasets, with many organizations finding that automated preprocessing reduces manual errors while accelerating model deployment timelines.
Practitioners face challenges including inconsistent data formats, missing or corrupted information, computational resource limitations, and varying data quality across sources. Processing unstructured text, images, and multimedia requires significant memory and processing power, while organizations often struggle with scalability issues, ultimately necessitating robust infrastructure and specialized tools to deliver clean, analysis-ready datasets efficiently.
Data preprocessing varies significantly across industries due to distinct regulatory requirements, data types, and business objectives. Healthcare focuses on patient privacy compliance, medical imaging standardization, and clinical data normalization, while finance emphasizes fraud detection algorithms, real-time transaction processing, and regulatory reporting accuracy, with both sectors finding that industry-specific preprocessing ultimately enhances operational efficiency and competitive advantage.
**INPUT**: What best practices should be followed for robust data preprocessing? **OUTPUT**: Robust data preprocessing best practices include comprehensive data profiling, systematic missing value handling, outlier detection and treatment, feature scaling, and thorough validation procedures. These methodologies streamline analytics workflows by ensuring data quality, reducing model bias, and enhancing predictive accuracy, with organizations across healthcare, finance, and retail finding that disciplined preprocessing ultimately delivers more reliable insights and competitive analytical advantage. [Word count: 60]
-
Very well designed and informative templates.
-
I’m not a design person, so I couldn’t make a presentation to save my life. Thankfully, they have all kinds of templates that I regularly use for my work.