

Techniques de modélisation des données Diapositives de présentation Powerpoint





Try Before you Buy Download Free Sample Product
 Impress Your
Audience
 100%
Editable
 Save Hours
of Time


La modélisation des données est le travail fondamental de base nécessaire à l'analyse des données et permet de stocker facilement les données dans la base de données. Saisissez notre modèle de techniques de modélisation des données conçu par des professionnels. Il donne un bref aperçu du modèle de données dans le SGBD et fournit des outils conceptuels pour expliquer l'architecture de la base de données à chaque niveau d'abstraction des données. Notre modèle de données dans le jeu de SGBD illustre le schéma de la base de données, illustrant les éléments de la base de données et leurs relations. Il contient des tables, des clés étrangères, des clés primaires, des vues, des colonnes, des types de données, des procédures stockées, etc. De plus, notre PPT Techniques de modélisation des données comprend les différentes étapes nécessaires à la création d'un modèle de données à l'aide de diverses techniques et outils. En outre, il présente les phases conceptuelles, logiques et physiques du modèle de données couvrant ses caractéristiques et ses avantages. Enfin, notre module d'architecture de modèle de données présente le modèle de données spécifique à l'industrie de la santé, de la BFSI, de la fabrication et de la vente au détail. Téléchargez notre modèle 100 % modifiable et personnalisable, également compatible avec Google Slides.
People who downloaded this PowerPoint presentation also viewed the following :
Contenu de cette présentation Powerpoint
Diapositive 1 : Cette diapositive présente les techniques de modélisation des données. Commencez par indiquer le nom de votre entreprise.
Diapositive 2 : Cette diapositive illustre l'ordre du jour de la présentation.
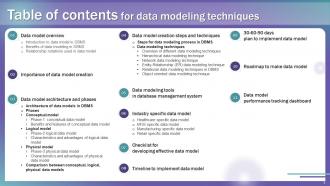
Diapositive 3 : Cette diapositive intègre la table des matières.
Diapositive 4 : Cette diapositive met en évidence le titre des sujets à discuter ensuite.
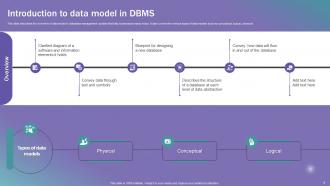
Diapositive 5 : Cette diapositive décrit la vue d'ensemble du modèle de données dans le système de gestion de base de données qui aide les entreprises de plusieurs façons.
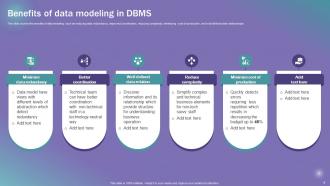
Diapositive 6 : Cette diapositive présente les avantages de la modélisation des données tels que la réduction de la redondance des données, l'amélioration de la coordination, etc.
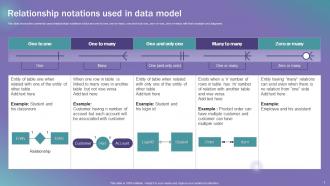
Diapositive 7 : Cette diapositive montre les notations de relations couramment utilisées.
Diapositive 8 : Cette diapositive comprend l'en-tête des composants à traiter plus en détail.
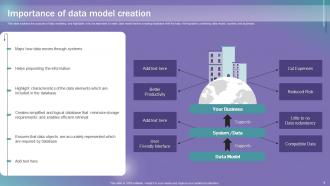
Diapositive 9 : Cette diapositive explique l'importance de la création d'un modèle de données.
Diapositive 10 : Cette diapositive révèle le titre des idées à couvrir dans le modèle suivant.
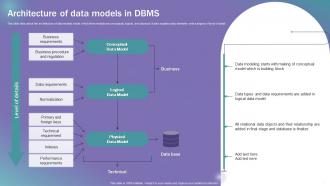
Diapositive 11 : Cette diapositive présente l'architecture des modèles de données à l'intérieur desquels trois modèles sont conceptuels, logiques et physiques.
Diapositive 12 : Cette diapositive affiche le titre des idées à discuter ensuite.
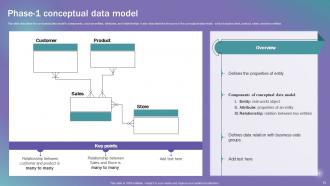
Diapositive 13 : Cette diapositive décrit les composants du modèle conceptuel de données, tels que les entités, les attributs, etc.
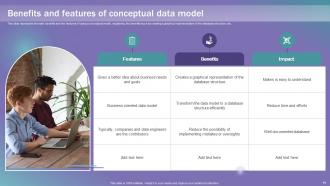
Diapositive 14 : Cette diapositive représente les principaux avantages et les caractéristiques de l'utilisation d'un modèle conceptuel.
Diapositive 15 : Cette diapositive mentionne le titre des sujets à traiter plus en détail.
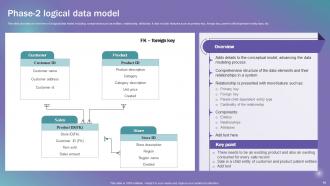
Diapositive 16 : Cette diapositive donne un aperçu d'un modèle logique de données.
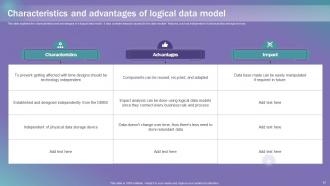
Diapositive 17 : Cette diapositive explique les caractéristiques et les avantages d'un modèle logique de données.
Diapositive 18 : Cette diapositive explique l'en-tête du contenu à discuter dans le modèle suivant.
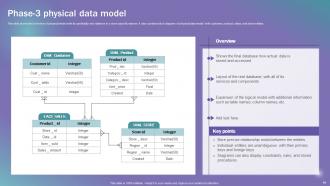
Diapositive 19 : Cette diapositive montre la vue d'ensemble du modèle physique avec sa cardinalité et ses relations d'une manière plus spécifique.
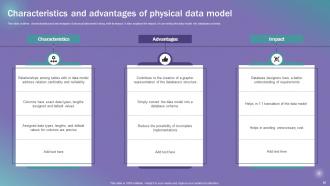
Diapositive 20 : Cette diapositive décrit les caractéristiques et les avantages du modèle physique de données ainsi que son impact.
Diapositive 21 : Cette diapositive indique le titre des idées à traiter plus en détail.
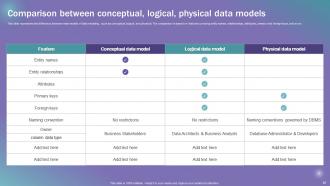
Diapositive 22 : Cette diapositive représente la différence entre les principaux modèles de modélisation des données.
Diapositive 23 : Cette diapositive présente l'en-tête des idées à discuter dans le modèle suivant.
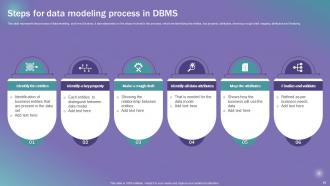
Diapositive 24 : Cette diapositive indique le processus de modélisation des données et comment cela se fait.
Diapositive 25 : Cette diapositive montre le titre du contenu à traiter plus en détail.
Diapositive 26 : Cette diapositive présente un aperçu détaillé des différentes techniques de modélisation des données.
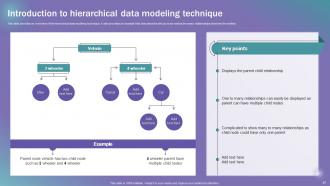
Diapositive 27 : Cette diapositive donne un aperçu de la technique de modélisation hiérarchique des données.
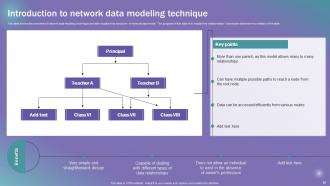
Diapositive 28 : Cette diapositive présente la vue d'ensemble de la technique de modélisation des données de réseau et explique également la structure du modèle de données de réseau.
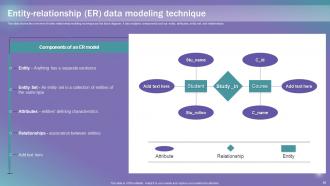
Diapositive 29 : Cette diapositive présente la vue d'ensemble de la technique de modélisation des relations d'entités et son schéma fonctionnel.
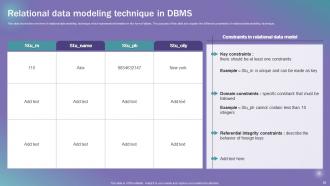
Diapositive 30 : Cette diapositive décrit la technique de modélisation relationnelle des données dans un SGBD.
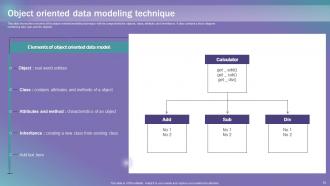
Diapositive 31 : Cette diapositive présente la vue d'ensemble de la technique de modélisation orientée objet avec ses composants.
Diapositive 32 : Cette diapositive révèle l'en-tête des sujets à aborder ensuite.
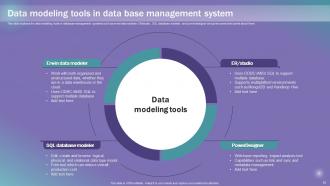
Diapositive 33 : Cette diapositive explique les outils de modélisation des données dans les systèmes de gestion de bases de données.
Diapositive 34 : Cette diapositive présente le titre des idées à traiter plus en détail.
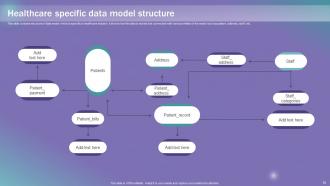
Diapositive 35 : Cette diapositive contient la structure du modèle de données spécifique au secteur de la santé.
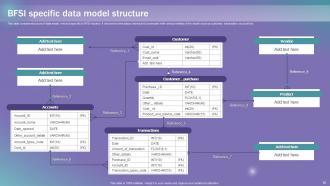
Diapositive 36 : Cette diapositive traite de la structure du modèle de données spécifique au BFSI.
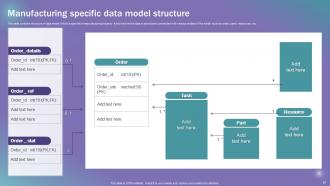
Diapositive 37 : Cette diapositive inclut la structure du modèle de données spécifique à l'industrie manufacturière.
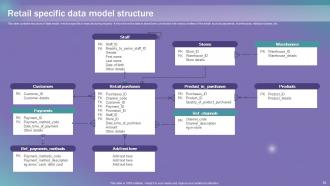
Diapositive 38 : Cette diapositive présente la structure du modèle de données spécifique à l'industrie manufacturière.
Diapositive 39 : Cette diapositive affiche l'en-tête des idées à discuter dans le modèle à venir.
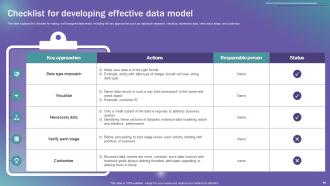
Diapositive 40 : Cette diapositive explique la liste de contrôle pour créer un modèle de données bien conçu.
Diapositive 41 : Cette diapositive présente le titre des sujets à traiter plus en détail.
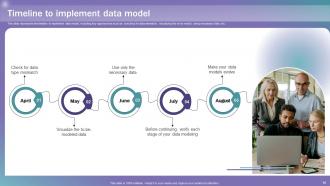
Diapositive 42 : Cette diapositive représente le calendrier de mise en œuvre du modèle de données.
Diapositive 43 : Cette diapositive explique l'en-tête des composants à discuter dans le modèle suivant.
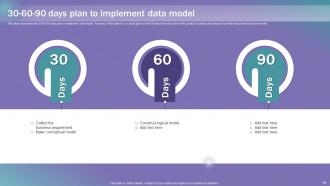
Diapositive 44 : Cette diapositive représente le plan de 30-60-90 jours pour mettre en œuvre le modèle de données.
Diapositive 45 : Cette diapositive révèle le titre des idées à traiter plus en détail.
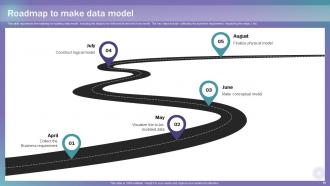
Diapositive 46 : Cette diapositive représente la feuille de route pour la construction du modèle de données.
Diapositive 47 : Cette diapositive présente le titre des idées à couvrir dans le modèle suivant.
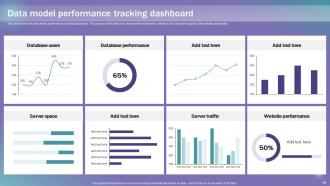
Diapositive 48 : cette diapositive présente le tableau de bord de suivi des performances du modèle de données.
Diapositive 49 : Il s'agit de la diapositive Icônes contenant toutes les icônes utilisées dans le plan.
Diapositive 50 : Cette diapositive présente des informations supplémentaires.
Diapositive 51 : Cette diapositive explique la mission, la vision et le but de l'organisation.
Diapositive 52 : Cette diapositive présente des informations relatives au sujet financier.
Diapositive 53 : Il s'agit de la diapositive du diagramme de Venn avec les images associées.
Diapositive 54 : Il s'agit de la diapositive de génération d'idées pour encourager les idées innovantes.
Diapositive 55 : Cette diapositive affiche l'analyse SWOT.
Diapositive 56 : Voici la diapositive Rencontrez notre équipe. Indiquez ici les informations relatives à votre équipe.
Diapositive 57 : Il s'agit de la diapositive Puzzle avec des images associées.
Diapositive 58 : Ceci est la diapositive de remerciement pour la reconnaissance.
Diapositives de présentation Powerpoint sur les techniques de modélisation des données avec les 63 diapositives :
Utilisez nos diapositives de présentation Powerpoint sur les techniques de modélisation des données pour vous aider efficacement à gagner un temps précieux. Ils sont prêts à l'emploi pour s'adapter à n'importe quelle structure de présentation.







FAQs for Data Modeling Techniques
So basically, conceptual is the bird's-eye view that your boss can actually understand - like "customers buy stuff." Logical adds more meat to the bones with actual attributes and keys, but you're not tied to any specific database yet. Physical? That's where things get messy with real table names, indexes, all that technical crud. Honestly, I always start conceptual because it's way easier to get everyone on the same page first. Then you can dive deeper into logical and finally physical when you're actually building the thing. Makes the whole process less painful.
So basically you want to split your data into separate tables and get rid of all that repeated stuff. Start with the normalization forms - 1NF, 2NF, then 3NF. Each piece of info should only exist once. Like instead of copying customer details over and over in your order records, just make a customers table and link to it with foreign keys. I know it seems like extra work upfront, but seriously, you'll thank yourself later when you need to change something. Look for functional dependencies between your fields - that'll show you where to split things. First step is removing those repeating groups, then deal with partial dependencies.
Think of ER modeling like sketching out a house plan before you build. Map out your main stuff - customers, orders, products - then draw how they connect. Yeah, it feels boring at first but seriously saves your butt later. Those diagrams help you catch redundant data and nail down your key relationships. I learned this the hard way on a project once. Always do the ER diagram before jumping into SQL. When your boss inevitably wants changes (and they will), you'll actually know what you're dealing with instead of guessing.
Database constraints are your first line of defense - foreign keys, check constraints, all that stuff. Then add business logic validation in your app layer to catch weird edge cases. Honestly, I'd set up some automated checks that run daily because finding corrupted data six months later is the worst. Normalize your tables properly so you're not duplicating everything everywhere. Oh, and get your data governance sorted early - trying to add integrity rules to messy existing data is basically hell. Short version: build these protections from day one, not as an afterthought.
So you'll need a junction table - basically a middle table that connects your two main tables. Take the primary keys from both sides and make them foreign keys in this new table. That breaks your many-to-many into two simpler one-to-many relationships. I've also heard people call it a bridge table or linking table, whatever floats your boat. Oh, and you can throw extra info in there too if you need it - like dates or quantities or whatever. First figure out which tables actually have that many-to-many thing going on, then build your junction table to sort it out.
So basically you want fact and dimension tables - facts are your measurable stuff like sales or clicks, dimensions give context like customer details and dates. Way more intuitive than those normalized schemas once you figure it out. Star schema makes everything faster and your analysts won't hate you for it. Plus it handles historical data pretty well with slowly changing dimensions. Oh, and start by figuring out your main business processes first, then build fact tables around those. Trust me, your reporting team will actually be able to use this stuff.
Start with entity and attribute names that actually make sense - no one should need a decoder ring. Document your relationships and business rules right in the model. Trust me, you'll hate yourself later if you don't. I always throw in a "last updated" field since these things change constantly. Store everything in version control with your code and write a basic README explaining the structure. Oh, and make it searchable! Your teammates will thank you when they're debugging some weird issue at 2am and can actually find what they need.
Honestly, data modeling is like organizing your closet - when there's a system, everything just works smoother. Your reports run faster. Dashboards actually make sense. Analysts don't waste time hunting through random tables for what they need. Here's the thing though - it prevents those super awkward situations where marketing and sales report totally different numbers for the same thing. I've seen that drama way too many times. My advice? Figure out your main business questions first, then build your model around those. Don't overthink it initially.
Honestly, just go with star schema for most stuff - queries run way faster since everything connects straight to your fact table. Snowflake's only worth it if you're super tight on storage or dealing with crazy complex hierarchies that would duplicate tons of data in a star setup. I mean, snowflake does normalize things better, but all those extra joins can really bog down performance. Had a project last year where we tried snowflake first and ended up switching back because queries were taking forever. Start with star and only switch if you actually run into storage issues. Trust me on this one.
Honestly, these tools are lifesavers for getting everyone on the same page. When you've got business people and developers looking at the same visual diagrams, nobody's confused about which data connects where. No more awkward meetings where someone goes "wait, what are we even talking about?" The visual stuff just makes sense to people - way better than trying to explain database relationships with words. Most tools let you add comments and see changes as they happen too. Oh, and definitely pick something your least tech-savvy person can actually use without wanting to throw their laptop.
Ugh, so basically unstructured data is a total pain because it won't play nice with normal database tables. Think messy text files, images, random social posts - none of that has clear rows and columns. You'll need NoSQL databases or ML models to make sense of it all. Honestly feels like organizing a teenager's bedroom vs. filing paperwork. Structured data? Easy relationships, clean queries. But with the messy stuff, figure out what you actually want to learn first. Then pick your tools. Way easier than going in blind.
Just add metadata fields to track where your data comes from - source systems, transformations, timestamps, all that. I always document each step with consistent naming (boring but necessary). Honestly, creating separate lineage tables alongside your main models feels like overkill until you're scrambling during an audit. Then you'll thank yourself. For critical stuff, map column-level lineage too. If you're dealing with tons of data, dbt or Apache Atlas can help automate this. Oh and maintain a data dictionary that shows upstream to downstream flows. Start with your most important pipelines first, don't try to do everything at once.
Honestly, you've gotta think about data growth from the start - like, how much data will you actually have in 2-3 years? Plan your partitioning and indexing around that, not just what you need today. Normalization feels nice and clean until you're doing crazy complex joins that tank your performance. Sometimes denormalizing for read-heavy stuff just works better, even if it feels "wrong." Also figure out your archiving strategy early - trust me on this one. Map out what queries you'll actually run at scale, then design around those realistic numbers instead of your current tiny dataset.
Dude, ML totally flips data modeling around. You stop obsessing over perfect normalized schemas upfront - instead you're throwing everything into messy, denormalized datasets first. Honestly way more fun than stressing about third normal form all the time! Data lakes become your friend over rigid warehouses. Your models have to deal with messier real-time stuff flowing through. The whole mindset shifts from "design it perfectly then build" to "build something flexible and iterate like crazy." Oh and your architecture? It's gonna evolve constantly as you experiment - just roll with it.
Honestly, the worst thing you can do is over-normalize everything from the start. Performance becomes a nightmare later. Also don't design in a vacuum - actually talk to the people who'll use this thing! I've seen way too many databases that look beautiful on paper but make zero sense when you're trying to write queries at 2am. Keep relationships simple enough that you won't hate yourself in six months. Think about how the data gets used, not just how clean it looks. Start basic, test with real scenarios, then tweak based on what actually performs well rather than chasing some perfect theoretical model.
-
No second thoughts when I’m looking for excellent templates. SlideTeam is definitely my go-to website for well-designed slides.
-
Spacious slides, just right to include text. SlideTeam has also helped us focus on the most important points that need to be highlighted for our clients.