

Diapositives de présentation PowerPoint pour les scientifiques des données




Try Before you Buy Download Free Sample Product
 Impress Your
Audience
 100%
Editable
 Save Hours
of Time


La science des données est un domaine d'étude qui combine l'expérience du domaine, les capacités informatiques et la compréhension mathématique et statistique pour extraire des informations précieuses des données. Voici un modèle de scientifique des données conçu de manière perspicace qui aidera grandement les entreprises à présenter un aperçu de leur scénario actuel et à évaluer la nécessité d'adopter la science des données. En outre, il contient des informations sur les exigences de l'adoption de la science des données, le cycle de vie et les phases de la science des données, et les composants critiques de la science des données. De plus, ce modèle de scientifique des données comprend les outils de science des données tels que SAS, Apache Spark, Excel, Tableau, NLP et TensorFlow, ainsi que ce rôle de la science des données dans la prise de décision. De plus, ce module met en évidence la différence entre la science des données et d'autres outils, le flux de travail de la science des données, les rôles professionnels dans la science des données et les principales applications de la science des données telles que les soins de santé, la logistique, la finance, les compagnies aériennes et les entreprises. Enfin, ce modèle comprend une liste de contrôle, un calendrier, une feuille de route, un plan de 30-60-90 jours, un tableau de bord et les impacts de l'intégration de la science des données sur l'organisation. Personnalisez ce modèle 100 % modifiable dès maintenant.
People who downloaded this PowerPoint presentation also viewed the following :
Contenu de cette présentation Powerpoint
Diapositive 1 : Cette diapositive présente Data Scientist. Indiquez le nom de votre entreprise et commencez.
Diapositive 2 : Il s'agit d'une diapositive d'ordre du jour. Indiquez ici vos agendas.
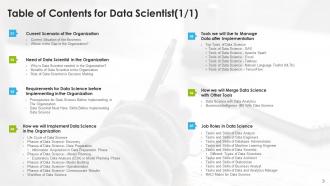
Diapositive 3 : Cette diapositive présente la table des matières de la présentation.
Diapositive 4 : Il s'agit d'une autre diapositive qui poursuit la table des matières de la présentation.
Diapositive 5 : Cette diapositive met en évidence le titre des sujets qui doivent être couverts ensuite dans le modèle.
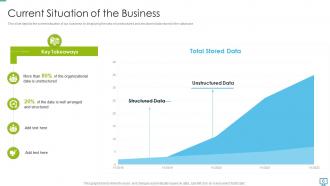
Diapositive 6 : Cette diapositive présente la situation actuelle de notre entreprise en affichant le ratio de données non structurées et structurées stockées dans la base de données.
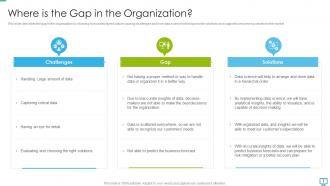
Diapositive 7 : Cette diapositive montre comment les données non structurées posent des problèmes et comment la science des données aidera à fournir des solutions.
Diapositive 8 : cette diapositive affiche la table des matières de la présentation.
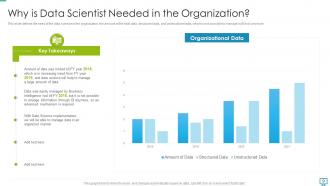
Diapositive 9 : Cette diapositive représente le besoin de la science des données dans l'organisation.
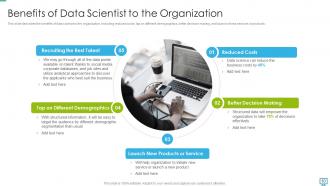
Diapositive 10 : Cette diapositive montre les avantages de la science des données pour l'organisation.
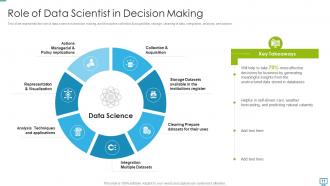
Diapositive 11 : Cette diapositive présente le rôle de la science des données dans la prise de décision, et comprend la collecte et l'acquisition, le stockage, le nettoyage des données, etc.
Diapositive 12 : Cette diapositive montre la table des matières de la présentation.
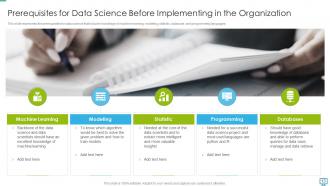
Diapositive 13 : cette diapositive présente les prérequis pour la science des données, notamment la connaissance de l'apprentissage automatique, de la modélisation, des statistiques, des bases de données et des langages de programmation.
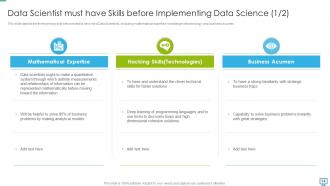
Diapositive 14 : Cette diapositive représente les compétences que doit avoir le scientifique des données avant de mettre en œuvre la science des données.
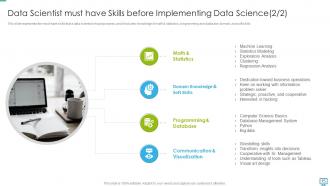
Diapositive 15 : Ceci est une autre diapositive montrant que le scientifique des données doit avoir des compétences avant de mettre en œuvre la science des données.
Diapositive 16 : Cette diapositive présente la table des matières de la présentation.
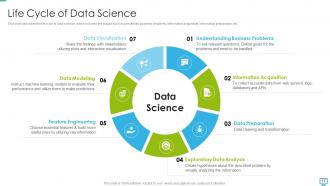
Diapositive 17 : Cette diapositive décrit le cycle de vie de la science des données, qui comprend les étapes telles que les problèmes métier prédéfinis, l'acquisition d'informations, etc.
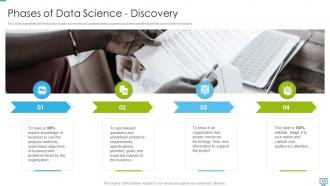
Diapositive 18 : Cette diapositive présente la première phase de la science des données qui consiste à comprendre les problèmes commerciaux et les faits qui relèvent de cette phase.
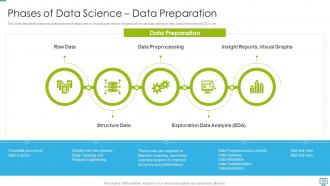
Diapositive 19 : Cette diapositive représente la phase de préparation des données de la science des données, y compris ses différentes étapes telles que les données brutes, les données structurées, le prétraitement des données, l'EDA, etc.
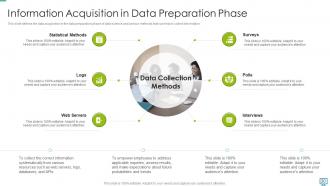
Diapositive 20 : Cette diapositive montre l'acquisition d'informations dans la phase de préparation des données.
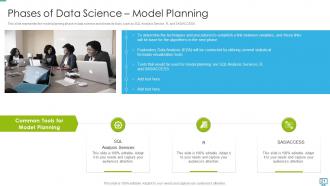
Diapositive 21 : Cette diapositive présente la phase de planification du modèle en science des données et montre ses outils, tels que SQL Analysis Service, R et SAS/ACCESS.
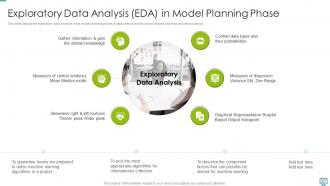
Diapositive 22 : Cette diapositive montre l'analyse exploratoire des données dans la phase de planification du modèle de la science des données et ses différentes étapes et raisons.
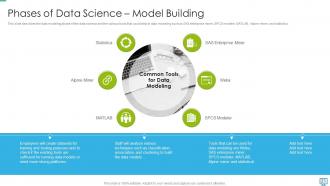
Diapositive 23 : Cette diapositive présente divers outils qui pourraient aider à la modélisation des données, tels que le mineur d'entreprise SAS, le modélisateur SPCS, MATLAB, etc.
Diapositive 24 : Cette diapositive représente la phase opérationnelle de la science des données et les tâches effectuées au cours de cette phase.
Diapositive 25 : Cette diapositive montre la dernière phase de la science des données et dans cette phase, toutes les principales conclusions sont communiquées aux parties prenantes.
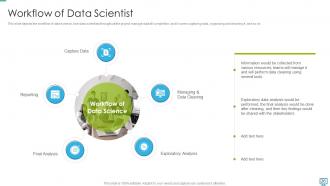
Diapositive 26 : Cette diapositive présente comment les data scientists tout au long du projet gèrent les données jusqu'à leur achèvement.
Diapositive 27 : Cette diapositive montre la table des matières de la présentation.
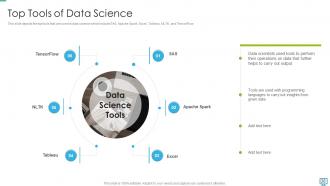
Diapositive 28 : Cette diapositive présente les principaux outils utilisés en science des données, notamment SAS, Apache Spark, Excel, etc.
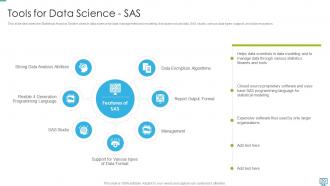
Diapositive 29 : Cette diapositive représente le système d'analyse statistique utilisé en science des données pour la gestion et la modélisation des données.
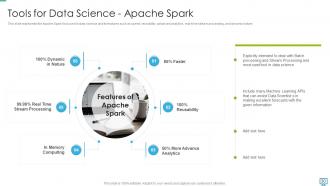
Diapositive 30 : Cette diapositive présente l'outil Apache Spark utilisé en science des données et ses fonctionnalités telles que la vitesse, la réutilisabilité, l'analyse avancée, etc.
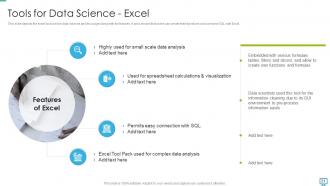
Diapositive 31 : Cette diapositive présente l'outil Excel utilisé en science des données et son utilisation ainsi que ses fonctionnalités.
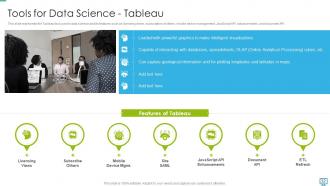
Diapositive 32 : Cette diapositive montre l'outil utilisé en science des données et ses fonctionnalités telles que les vues de licence, l'abonnement des autres, etc.
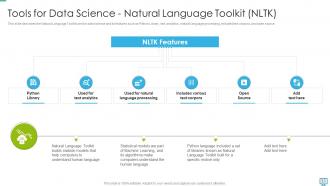
Diapositive 33 : Cette diapositive affiche Outils pour la science des données - Boîte à outils en langage naturel (NLTK).
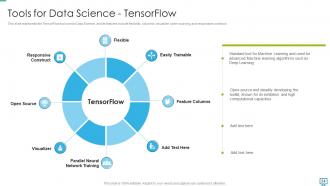
Diapositive 34 : cette diapositive représente l'outil TensorFlow utilisé en science des données, et ses fonctionnalités incluent la flexibilité, les colonnes, le visualiseur, etc.
Diapositive 35 : Cette diapositive montre la table des matières de la présentation.
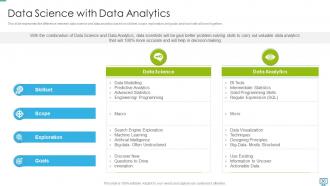
Diapositive 36 : Cette diapositive présente la différence entre la science des données et l'analyse des données en fonction des compétences, de la portée, de l'exploration et des objectifs.
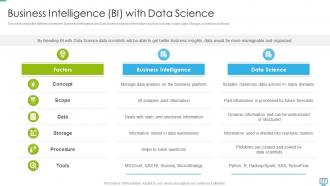
Diapositive 37 : Cette diapositive montre la différence entre la Business Intelligence et la Data Science en fonction de facteurs tels que le concept, la portée, les données, etc.
Diapositive 38 : cette diapositive affiche la table des matières de la présentation.
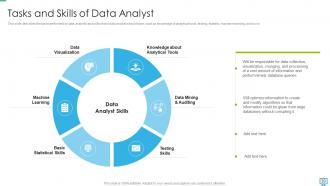
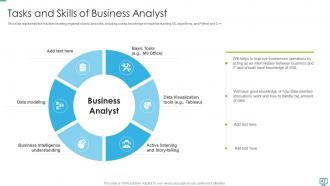
Diapositive 39 : Cette diapositive représente les tâches effectuées par l'analyste d'affaires et comment il sera utile pour améliorer les opérations commerciales.
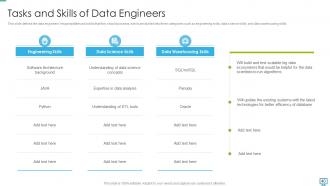
Diapositive 40 : Cette diapositive montre les responsabilités et les compétences des ingénieurs de données qu'ils doivent posséder.
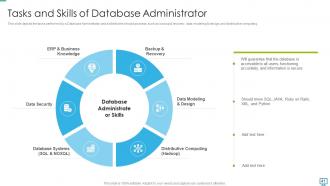
Diapositive 41 : Cette diapositive présente les tâches effectuées par un administrateur de base de données et les compétences qu'il doit posséder.
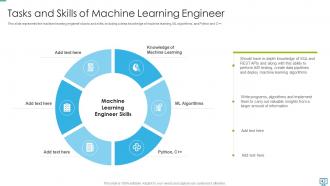
Diapositive 42 : cette diapositive montre les tâches et les compétences d'un ingénieur en apprentissage automatique, y compris une connaissance approfondie de l'apprentissage automatique, des algorithmes ML, ainsi que de Python et C++.
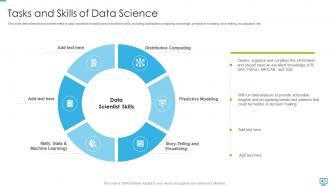
Diapositive 43 : Cette diapositive présente les tâches réalisées par les data scientists en science des données et leurs compétences.
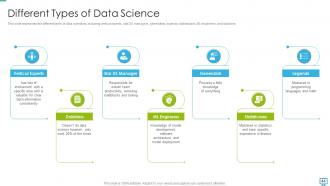
Slide 44 : Cette slide représente les différents types de data scientists, dont les experts verticaux, les stat DS managers, les généralistes, etc.
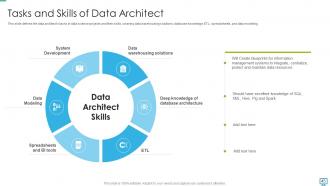
Diapositive 45 : Cette diapositive montre les tâches des architectes de données dans les projets de science des données et leurs compétences.
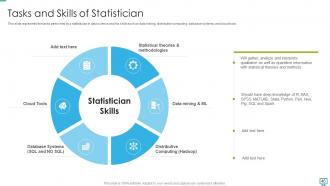
Diapositive 46 : Cette diapositive présente les tâches effectuées par un statisticien en science des données et ses compétences telles que l'exploration de données, l'informatique distributive, etc.
Diapositive 47 : Cette diapositive montre les tâches effectuées par l'analyste d'affaires et comment il sera utile pour améliorer les opérations commerciales.
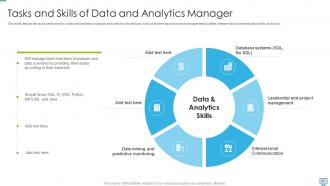
Diapositive 48 : Cette diapositive présente les tâches effectuées par un gestionnaire de données et d'analyses et les compétences qu'il doit posséder.
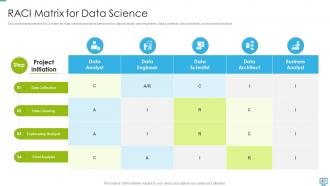
Diapositive 49 : Cette diapositive représente la matrice RACI pour la science des données et les tâches effectuées par les analystes de données, les ingénieurs de données, les scientifiques de données, etc.
Diapositive 50 : Cette diapositive montre la table des matières mettant en évidence la liste de contrôle pour une intégration efficace de la science des données dans les entreprises.
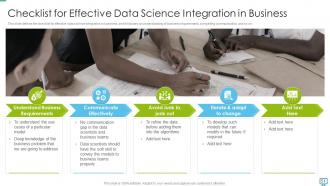
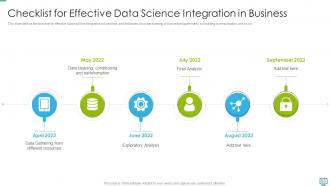
Diapositive 51 : Cette diapositive présente la liste de contrôle pour une intégration efficace de la science des données dans les entreprises.
Diapositive 52 : Cette diapositive montre la table des matières mettant en évidence le calendrier de mise en œuvre de la science des données dans l'organisation.
Diapositive 53 : Cette diapositive affiche la table des matières mettant en évidence le calendrier de mise en œuvre de la science des données dans l'organisation.
Diapositive 54 : Cette diapositive représente la table des matières mettant en évidence la feuille de route pour intégrer la science des données dans l'organisation.
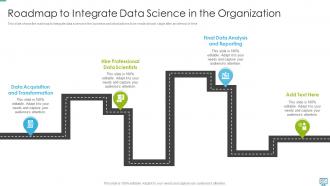
Diapositive 55 : Cette diapositive montre la feuille de route pour intégrer la science des données dans l'organisation.
Diapositive 56 : Cette diapositive présente la table des matières mettant en évidence le plan de 30-60-90 jours pour la mise en œuvre de la science des données.
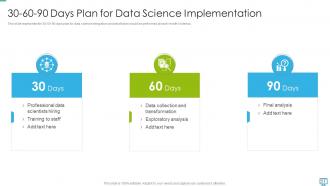
Diapositive 57 : Cette diapositive montre un plan de 30-60-90 jours pour la mise en œuvre de la science des données.
Diapositive 58 : cette diapositive affiche le tableau de bord pour la mise en œuvre de la science des données.
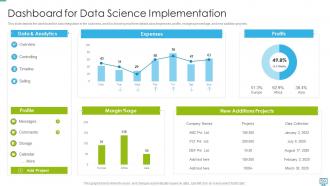
Diapositive 59 : Cette diapositive représente le tableau de bord pour l'intégration des données dans l'entreprise et affiche des détails en temps réel sur les dépenses, les bénéfices, le pourcentage de marges, etc.
Diapositive 60 : Cette diapositive montre la table des matières mettant en évidence les impacts de l'intégration de la science des données dans l'organisation.
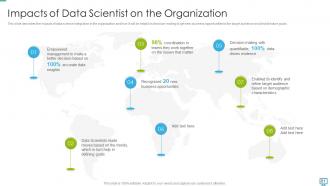
Diapositive 61 : Cette diapositive présente les impacts de l'intégration de la science des données dans l'organisation.
Diapositive 62 : Cette diapositive montre la table des matières de la présentation.
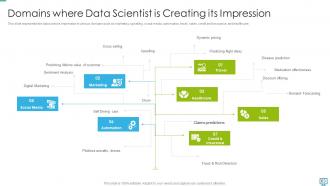
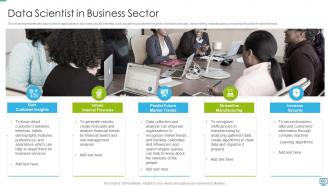
Diapositive 63 : Cette diapositive affiche les domaines où la science des données crée son impression.
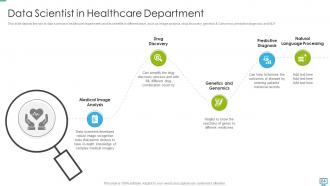
Diapositive 64 : Cette diapositive représente la science des données dans les services de santé et ses avantages de différentes manières.
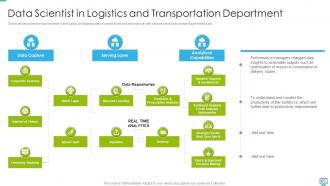
Diapositive 65 : Cette diapositive montre la science des données dans le département de la logistique et du transport.
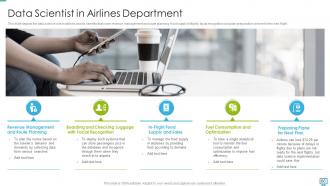
Diapositive 66 : Cette diapositive présente le rôle de la science des données dans les compagnies aériennes et ses avantages qui couvrent la gestion des revenus et la planification des itinéraires.
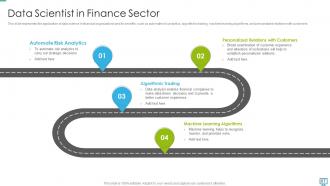
Diapositive 67 : Cette diapositive montre l'application de la science des données dans les organisations financières et ses avantages.
Diapositive 68 : Cette diapositive présente l'application de la science des données en entreprise et ses avantages.
Diapositive 69 : cette diapositive affiche des icônes pour Data Scientist.
Diapositive 70 : Cette diapositive met en évidence le titre des sujets qui doivent être couverts ensuite dans le modèle.
Diapositive 71 : Cette diapositive est intitulée Diapositives supplémentaires pour aller de l'avant.
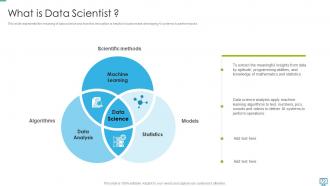
Diapositive 72 : Cette diapositive représente la signification de la science des données et comment cette innovation est utile aux entreprises qui développent des systèmes d'IA.
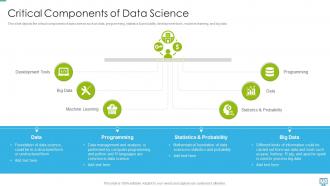
Diapositive 73 : Cette diapositive décrit les composants critiques de la science des données tels que les données, la programmation, les statistiques, etc.
Diapositive 74 : cette diapositive contient un puzzle avec des icônes et du texte associés.
Diapositive 75 : Cette diapositive fournit un plan de 30 60 90 jours avec des zones de texte.
Diapositive 76 : Il s'agit d'une diapositive de génération d'idées pour énoncer une nouvelle idée ou mettre en évidence des informations, des spécifications, etc.
Diapositive 77 : Il s'agit d'une diapositive de chronologie. Afficher les données relatives aux intervalles de temps ici.
Diapositive 78 : Cette diapositive montre des post-it. Postez vos notes importantes ici.
Diapositive 79 : Cette diapositive décrit un tableau combiné avec une comparaison de deux produits.
Diapositive 80 : Voici la diapositive Notre objectif. Indiquez ici les objectifs de votre entreprise.
Diapositive 81 : cette diapositive présente la feuille de route avec des zones de texte supplémentaires.
Diapositive 82 : Il s'agit d'une diapositive de remerciement avec l'adresse, les numéros de contact et l'adresse e-mail.
Diapositives de présentation powerpoint du scientifique des données avec les 87 diapositives :
Utilisez nos diapositives de présentation Powerpoint Data Scientist pour vous aider efficacement à gagner un temps précieux. Ils sont prêts à l'emploi pour s'adapter à n'importe quelle structure de présentation.





FAQs for Data scientist
Get solid with Python or R first, plus SQL and basic stats. Machine learning comes next - learn when different algorithms actually make sense, not just how to run them. But here's the thing nobody talks about enough: communication skills will make or break you. You'll spend half your time explaining why your fancy model matters to people who just want simple answers. Critical thinking is huge too. Domain knowledge in whatever industry you're targeting? That's where you'll actually stand out. Start with whichever area feels shakiest - probably the technical stuff if you're like most people.
First figure out what you're actually trying to do - predict stuff, spot patterns, or sort data into buckets. Your dataset matters too. Big or small? Clean or a total disaster? (Usually it's a disaster lol). Sometimes your boss will want to know WHY the model made a decision, not just if it's right. I always start simple though - linear regression, decision trees, that kind of thing. Don't jump straight to neural networks just because they're fancy. Test basic stuff first, then get more complex if you need better results.
Oh man, data cleaning is such a pain but you'll literally spend like 70% of your time on it. Way more than the actual fun modeling part, which sucks but whatever. You gotta deal with missing values, duplicates, weird inconsistencies - all that boring stuff before you can do anything useful. Your models are only gonna be as good as your data, so if you skip this step you're basically screwed. I learned this the hard way lol. Seriously though, budget way more time than you think you'll need. Oh and profile your dataset first so you know what mess you're dealing with.
Honestly, good visualizations are like telling a story instead of just throwing spreadsheets at people. You're basically walking them through what matters rather than making them decode everything themselves. The magic happens when someone looks at your chart and goes "oh shit, NOW I see it." That's way better than endless tables nobody wants to read. Charts can actually build suspense - weird but true. I always sketch out what story I'm trying to tell first, then figure out which visuals will actually support that. Don't just pick whatever looks pretty in Excel.
First thing - make sure people actually said yes to how you're using their stuff. Anonymize properly too, not just scrubbing names but really making it untraceable. Store everything securely and don't hoard data longer than you need it. Be upfront about any bias in your algorithms that might screw over certain groups. Honestly, most people skip the consent part and it bites them later. Short version: would you be cool with someone doing this to your personal info? If not, don't do it.
Honestly, I just make it part of my routine now. Twitter's surprisingly great for this - researchers drop new stuff there all the time. I follow Towards Data Science and get newsletters from KDnuggets too. Reddit's data science communities are solid for real talk from people actually doing the work. Kaggle competitions show you what's trending technique-wise, which is pretty useful. Virtual conferences are hit or miss but worth checking out. Online courses help when there's a totally new tool everyone's buzzing about. The trick is staying consistent instead of panicking when you realize you're three trends behind.
Look, Python and R are the big players for a reason. Python's great for machine learning and data stuff - pandas, scikit-learn, matplotlib are solid libraries. R crushes statistical analysis and has incredible specialized packages. Don't sleep on SQL either, you'll be querying databases nonstop. The Python vs R flame wars are honestly pretty entertaining to watch online. Most companies just pick one though. If you're starting fresh, go Python - way more versatile and the job market's insane right now. Get good at one first, then you can always pick up others later depending on what you need.
So ML is all about training algorithms to spot patterns and make predictions from tons of data. You're not coding specific rules - the system learns them. Traditional stats? That's more for testing theories and figuring out *why* relationships exist between variables. Like, if you want to prove something causes something else, go with stats. Need to predict what'll happen next? ML's your friend. Honestly though, the boundaries get messy and most real projects end up mixing both approaches anyway. I'd say start by asking yourself: do you want to explain something or predict it?
Honestly? Data cleaning will eat up way more time than you think - missing values, weird formats, just messy stuff everywhere. Stakeholders love changing their minds halfway through too, which is super fun. Model selection gets tricky, especially when departments won't share their data with each other. But here's the thing that really kills projects: nobody can translate tech speak into business language. I swear, communication problems wreck more data science work than crappy algorithms ever will. My two cents? Get really clear on what people actually want upfront. Makes everything smoother later.
Dude, you absolutely need those other teams on your side. Marketing has to get what your models actually mean for customers, otherwise they'll just ignore your work. And don't even get me started on IT - they're the ones who'll make or break your stuff in production. I've watched so many genius analyses just die on people's laptops because nobody talked to each other! Marketing can tell you if your insights are total nonsense from a business perspective. IT will catch the stuff that'll blow up their servers. Honestly? Set up regular meetings with both teams right when you start any project.
Dude, big data completely flipped data science on its head. We went from nice, tidy datasets to wrestling with absolute chaos - like terabytes of messy info flowing constantly. You'll need Spark and Hadoop now just to handle the sheer volume. Machine learning that used to take hours? Now it's gotta crunch massive amounts in real-time. Honestly, the scale shift is insane. But here's the cool part - you can spot patterns that were totally invisible with smaller samples. Oh, and definitely get comfortable with cloud platforms soon. Your laptop isn't gonna cut it anymore, trust me.
Honestly, Python and R are where it's at for coding - Python's my favorite since you can use it for way more than just data stuff. Jupyter notebooks are like my second home at this point lol. You'll need SQL for databases obviously, and cloud stuff like AWS or Google Cloud is pretty much required now. Tableau and Power BI cover most viz work. For libraries, pandas and scikit-learn are clutch, plus TensorFlow if you get into ML. Don't sleep on GitHub either. Start with Python and SQL, then maybe pick one cloud platform to dive into.
Domain knowledge makes a huge difference in data science work. You'll ask better questions and catch patterns that actually matter. I've watched people build perfect models that solve totally wrong problems - kinda painful to see honestly. Without understanding the business, you might waste weeks on features that any domain expert would immediately flag as useless. Plus you can explain your results in ways stakeholders will care about. The best thing? Just hang out with people who know the field inside and out. They'll teach you more than any textbook.
Look, track whether your model actually fixes the business problem first. Revenue up? Costs down? That's what matters. Technical stuff like accuracy is obviously important too, but I've watched "amazing" models sit unused because they didn't fit how people work. User adoption is everything - if stakeholders won't use it, you've basically wasted everyone's time. Make sure it's explainable enough that people trust the outputs. Oh, and integration can't be a nightmare. Honestly though, figure out these success metrics with your team before you start building anything. Saves so much headache later.
So basically you gotta split your data - training, validation, test sets. Don't test on stuff the model's already seen, that's cheating lol. Cross-validation catches overfitting before it becomes a nightmare. Accuracy isn't everything though, check other metrics too depending on your data. Edge cases will break things in weird ways, trust me on this one. Oh and data drift is annoying but real - your model won't perform the same forever. Set up monitoring early so you're not scrambling when things go sideways. Automate what you can.
-
Excellent template with unique design.
-
Excellent work done on template design and graphics.