

Grundlagen des Trainings für künstliche neuronale Netze Ppt





Try Before you Buy Download Free Sample Product
 Impress Your
Audience
 100%
Editable
 Save Hours
of Time


Diese Folien diskutieren das Konzept künstlicher neuronaler Netze. Es gibt drei Schichten im neuronalen Netzwerk: die Eingabeschicht, die verborgene Schicht und die Ausgabeschicht. Mithilfe der Aktivierungsfunktion wird eine gewichtete Summe berechnet und anschließend ein Bias hinzugefügt, um zu bestimmen, ob ein Neuron aktiviert werden soll oder nicht. Es beschreibt auch die Funktionsweise eines neuronalen Netzwerks. Es erklärt auch den Gradientenabstieg und die Rückausbreitung.
People who downloaded this PowerPoint presentation also viewed the following :
Inhalt dieser Powerpoint-Präsentation
Folie 1
Diese Folie zeigt eine Trennfolie für die Sitzungseinführung in die Vertriebsgrundlagen.
Folie 2
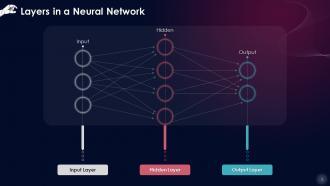
Diese Folie zeigt die Schichten in einem neuronalen Netzwerk. Es gibt drei Ebenen, die als Eingabeebene, verborgene Ebene und Ausgabeebene bekannt sind.
Anmerkungen des Kursleiters:
- Eingabeschicht: Die Eingabeschicht steht an erster Stelle. Diese Schicht akzeptiert die Daten und sendet sie dann an den Rest des Netzwerks
- Verborgene Ebene: Die verborgene Ebene ist die zweite der drei Ebenen. Die verborgenen Schichten eines neuronalen Netzwerks können eine oder mehrere sein. Die verborgenen Schichten sind diejenigen, die für die hohe Leistung und Komplexität neuronaler Netze verantwortlich sind. Sie können mehrere Aufgaben gleichzeitig erledigen, z. B. Datentransformation, automatische Funktionsentwicklung usw
- Ausgabeebene: Die Ausgabeebene ist die letzte Ebene. Das Ergebnis oder die Ausgabe des Problems wird in der Ausgabeschicht gespeichert. Die Eingabeebene empfängt Rohfotos und die Ausgabeebene liefert die endgültige Version des Ergebnisses
Folie 3
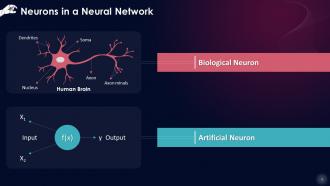
Diese Folie veranschaulicht die künstlichen Neuronen, die in den Schichten eines künstlichen neuronalen Netzwerks (KNN) vorhanden sind. Es wird ein Vergleich zwischen den im menschlichen Gehirn vorhandenen biologischen Neuronen und einem künstlichen Neuron in einem KNN gezogen.
Hinweise für den Kursleiter: Eine Schicht besteht aus mikroskopischen Einheiten, die als Neuronen bekannt sind. Mit Hilfe biologischer Neuronen lässt sich ein Neuron in einem neuronalen Netzwerk besser verstehen. Ein künstliches Neuron ist analog zu einem biologischen Neuron. Es nimmt Informationen von anderen Neuronen entgegen, verarbeitet sie und erzeugt dann eine Ausgabe. Hier sind X1 und X2 die Eingaben der künstlichen Neuronen, f(X) ist die Verarbeitung der Eingaben und y ist die Ausgabe des Neurons.
Folie 4
Diese Folie gibt eine Einführung in die Aktivierungsfunktion in einem neuronalen Netzwerk und diskutiert ihre Bedeutung. Mithilfe der Aktivierungsfunktion wird eine gewichtete Summe berechnet und anschließend ein Bias hinzugefügt, um zu bestimmen, ob ein Neuron aktiviert werden soll oder nicht.
Folie 5
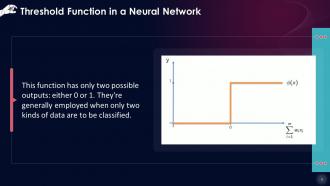
Diese Folie veranschaulicht die Schwellenwertfunktion, eine Art Aktivierungsfunktion in einem neuronalen Netzwerk. Diese Funktion hat nur zwei mögliche Ausgaben: entweder 0 oder 1. Sie werden im Allgemeinen verwendet, wenn nur zwei Arten von Daten klassifiziert werden sollen.
Folie 6
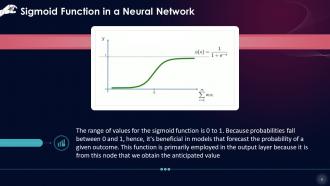
Diese Folie zeigt die Sigmoidfunktion, eine Art Aktivierungsfunktion. Der Wertebereich der Sigmoidfunktion liegt zwischen 0 und 1. Diese Funktion wird hauptsächlich in der Ausgabeschicht verwendet, da wir von diesem Knoten aus den erwarteten Wert erhalten
Folie 7
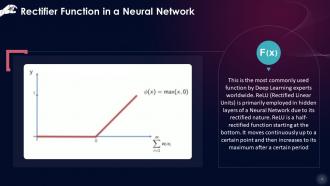
Diese Folie veranschaulicht die Rectifier- oder ReLU-Funktion, eine Art Aktivierungsfunktion. Relu (Rectified Linear Units) wird aufgrund seiner gleichgerichteten Natur hauptsächlich in verborgenen Schichten eines neuronalen Netzwerks eingesetzt. Relu ist eine halbkorrigierte Funktion, die unten beginnt. Sie bewegt sich kontinuierlich bis zu einem bestimmten Punkt und steigt dann nach einer bestimmten Zeitspanne auf ihr Maximum an
Folie 8
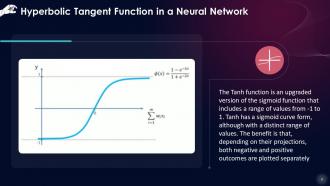
Diese Folie zeigt die hyperbolische Tangensfunktion, eine Art Aktivierungsfunktion. Die Tanh-Funktion ist eine aktualisierte Version der Sigmoidfunktion, die einen Wertebereich von -1 bis 1 umfasst. Tanh hat eine Sigmoidkurvenform, allerdings mit einem ausgeprägten Wertebereich. Der Vorteil besteht darin, dass je nach Prognose sowohl negative als auch positive Ergebnisse getrennt dargestellt werden
Folie 9
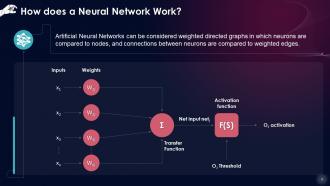
Diese Folie beschreibt die Funktionsweise eines künstlichen neuronalen Netzwerks. Künstliche neuronale Netze können als gewichtete gerichtete Graphen betrachtet werden, in denen Neuronen mit Knoten und Verbindungen zwischen Neuronen mit gewichteten Kanten verglichen werden.
Hinweise für den Kursleiter: Das Verarbeitungselement eines Neurons empfängt viele Signale, die gelegentlich an der Empfangssynapse verändert werden, bevor sie am Verarbeitungselement summiert werden. Wenn es den Schwellenwert erreicht, wird es zu einem Input für andere Neuronen und der Zyklus beginnt von neuem
Folie 10
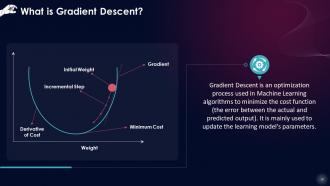
Auf dieser Folie wird das Konzept des Gradientenabstiegs vorgestellt. Gradient Descent ist ein Optimierungsprozess, der in Algorithmen des maschinellen Lernens verwendet wird, um die Kostenfunktion (den Fehler zwischen der tatsächlichen und der vorhergesagten Ausgabe) zu minimieren. Es wird hauptsächlich zum Aktualisieren der Parameter des Lernmodells verwendet.
Folie 11
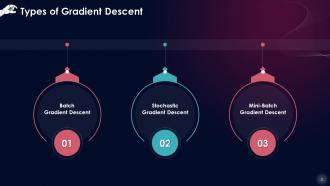
Auf dieser Folie werden die Arten des Gradientenabstiegs aufgeführt. Dazu gehören Batch-Gradientenabstieg, stochastischer Gradientenabstieg und Mini-Batch-Gradientenabstieg.
Anmerkungen des Kursleiters:
- Batch-Gradientenabstieg: Der Batch-Gradientenabstieg fügt die Fehler für jeden Punkt in einem Trainingssatz hinzu, bevor das Modell aktualisiert wird, nachdem alle Trainingsinstanzen überprüft wurden. Dieser Prozess wird als Trainingsepoche bezeichnet. Der Batch-Gradientenabstieg führt normalerweise zu einem stetigen Fehlergradienten und einer stetigen Konvergenz, obwohl die Wahl des lokalen Minimums anstelle des globalen Minimums nicht immer die beste Lösung ist
- Stochastischer Gradientenabstieg: Der stochastische Gradientenabstieg erstellt eine Trainingsepoche für jedes Beispiel im Datensatz und ändert die Parameter jedes Trainingsbeispiels nacheinander. Diese häufigen Aktualisierungen können zu mehr Details und Geschwindigkeit führen, können aber auch zu verrauschten Farbverläufen führen, die dabei helfen können, das lokale Minimum zu überschreiten und das globale Minimum zu lokalisieren
- Mini-Batch-Gradientenabstieg: Der Mini-Batch-Gradientenabstieg kombiniert die Prinzipien des Batch-Gradientenabstiegs und des stochastischen Gradientenabstiegs. Es unterteilt den Trainingsdatensatz in verschiedene Gruppen und aktualisiert diese separat. Diese Methode gleicht die Recheneffizienz des Batch-Gradientenabstiegs und die Geschwindigkeit des stochastischen Gradientenabstiegs aus
Folie 12
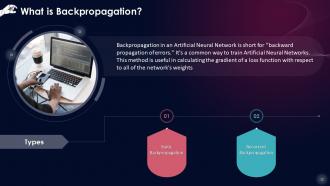
Auf dieser Folie wird das Konzept der Backpropagation zusammen mit ihren beiden Typen beschrieben: statische Backpropagation und wiederkehrende Backpropagation. Backpropagation ist nützlich bei der Berechnung des Gradienten einer Verlustfunktion in Bezug auf alle Gewichte des Netzwerks.
Anmerkungen des Kursleiters:
- Statische Backpropagation: Die Zuordnung statischer Eingaben erzeugt bei dieser Art der Backpropagation eine statische Ausgabe. Es wird verwendet, um Herausforderungen wie die optische Zeichenerkennung zu bewältigen, die eine statische Klassifizierung erfordert
- Wiederkehrende Rückausbreitung: Die wiederkehrende Rückausbreitung wird vorwärts gerichtet oder durchgeführt, bis ein bestimmter eingestellter Wert oder Schwellenwert erreicht wird. Der Fehler wird nach Erreichen eines bestimmten Werts ausgewertet und rückwärts propagiert
Folie 13
Auf dieser Folie werden die Vorteile der Backpropagation aufgeführt. Diese sind einfach und unkompliziert, anpassungsfähig und effizient und erfordern keine besonderen Eigenschaften.
Folie 14
Auf dieser Folie werden die Nachteile der Backpropagation aufgeführt. Diese bestehen darin, dass die Dateneingabe die Funktion des gesamten Netzwerks zu einem bestimmten Thema bestimmt, Netzwerke anfällig für verrauschte Daten sind und eine Matrix-basierte Technik verwendet wird.
Folie 15
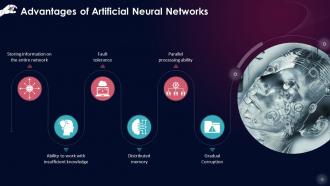
Diese Folie listet die Vorteile künstlicher neuronaler Netze auf. Zu diesen Vorteilen gehören, dass ANN Informationen über das gesamte Netzwerk speichert, seine Fähigkeit, mit unzureichendem Wissen zu arbeiten, seine Fehlertoleranz, ein verteilter Speicher und die Fähigkeit zur parallelen Verarbeitung.
Hinweise des Dozenten:
- Speichern von Informationen im gesamten Netzwerk: Informationen werden im gesamten Netzwerk gespeichert und nicht in einer Datenbank, wie dies bei der herkömmlichen Programmierung der Fall ist. Das Netzwerk funktioniert weiterhin, obwohl an einem Ort einige Informationen verloren gehen
- Fähigkeit, mit unzureichendem Wissen zu arbeiten: Nach dem Training des künstlichen neuronalen Netzwerks können die Daten auch bei begrenzten oder unzureichenden Informationen zu Ergebnissen führen
- Fehlertoleranz: Die Ausgabe eines KNN bleibt von der Beschädigung einer oder mehrerer seiner Zellen unberührt. Durch diese Eigenschaft werden die Netzwerke fehlertolerant
- Verteilter Speicher: Es ist erforderlich, die Beispiele zu ermitteln und das Netzwerk entsprechend der beabsichtigten Ausgabe zu trainieren. Der Fortschritt des Netzwerks ist proportional zu den ausgewählten Instanzen. Wenn das Ereignis nicht in allen Aspekten im Netzwerk angezeigt werden kann, kann es zu ungenauen Ergebnissen kommen
- Fähigkeit zur Parallelverarbeitung: Künstliche neuronale Netze verfügen über die Rechenleistung, um mehrere Aufgaben gleichzeitig auszuführen
- Allmähliche Korruption: Das Netzwerk wird nicht sofort korrodiert, da seine Leistung mit der Zeit nachlässt und langsamer wird.
Folie 16
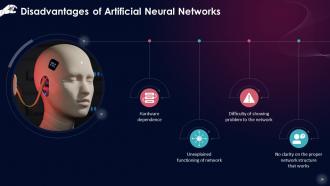
Diese Folie listet die Nachteile künstlicher neuronaler Netze auf. Zu diesen Nachteilen gehören die Hardwareabhängigkeit von ANNs, die ungeklärte Funktionsweise des Netzwerks, die Schwierigkeit, dem Netzwerk Probleme anzuzeigen, und keine Klarheit über die ordnungsgemäße Netzwerkstruktur, die funktioniert.
Hinweise des Dozenten:
- Hardwareabhängigkeit: Die Struktur künstlicher neuronaler Netze erfordert parallele Rechenleistung. Daher ist die Implementierung geräteabhängig
- Unerklärte Funktionsweise des Netzwerks: Wenn ANN eine Sondierungslösung bereitstellt, erklärt dies nicht, warum oder wie diese ausgewählt wurde. Dies verringert das Vertrauen in das Netzwerk
- Schwierigkeiten, das Problem dem Netzwerk anzuzeigen: ANNs sind in der Lage, mit numerischen Daten zu arbeiten. Bevor ANN in ein Problem eingeführt wird, muss es in numerische Werte umgewandelt werden. Der hier gewählte Anzeigemechanismus wirkt sich je nach Kenntnisstand des Benutzers direkt auf die Leistung des Netzwerks aus
- Keine Klarheit über die richtige Netzwerkstruktur, die funktioniert: Keine explizite Regel bestimmt die Struktur künstlicher neuronaler Netzwerke. Durch Erfahrung und Trial & Error wird die ideale Netzwerkstruktur geschaffen
Grundlagen des Trainings-Ppt für künstliche neuronale Netze mit allen 32 Folien:
Nutzen Sie unser Schulungs-PPT „Grundlagen künstlicher neuronaler Netze“, um effektiv wertvolle Zeit zu sparen. Sie sind gebrauchsfertig und passen in jede Präsentationsstruktur.





FAQs for Essentials Of Artificial Neural
So basically you've got neurons (the nodes) connected in layers - input layer takes your data, hidden layers do all the heavy lifting, then output spits out results. Each connection has weights that control how strong the signal is, and that's where all the learning magic happens during training. Think of neurons like tiny decision-makers that either "fire" or stay quiet based on their activation function. The tricky part is figuring out how many hidden layers you actually need - honestly depends on how complex your problem is. Oh and the weights between connections? That's literally what makes or breaks your whole network.
So basically backpropagation figures out which weights screwed up your prediction and by how much. It starts at the output layer and works backwards through each layer - kinda like detective work but with calculus. The chain rule helps you calculate gradients for every weight, then gradient descent updates them to reduce error. Honestly took me forever to get this concept when I first learned it. Short version: you're tracing responsibility backwards through the network. I'd definitely start with just two layers first - the math gets wild once you add more depth, trust me.
So learning rate is basically how big steps your model takes when updating weights - like the "speed" it learns at. Go too high? Your model bounces around like crazy and never settles on the right answer. Too low and it'll take forever, might even get stuck. Honestly such a pain to get right lol. You want steady loss decrease without wild swings. I usually start with 0.001 or 0.01, then mess around with schedules that slow down over time. Works way better for fine-tuning that way.
Oh yeah, overfitting is annoying but totally fixable. Dropout is your best friend - try 0.2 to 0.5 and it randomly shuts off neurons so your model can't just memorize everything. Early stopping works great too, just watch when validation loss starts climbing while training loss keeps dropping. That's when you know to quit. More data always helps if you can swing it, or try data augmentation to fake having more. Cross-validation gives you a better picture of what's actually happening. Honestly, I'd start with dropout and early stopping since they're pretty foolproof.
Imbalanced data is such a pain, but there's a few things that actually work. Class weighting is probably your best starting point - it just makes the model care more about getting the minority class right. SMOTE is solid for creating synthetic examples of your rare class, or you could undersample the majority one instead. Focal loss is pretty neat too since it makes the model focus on the tricky examples it keeps getting wrong. Oh, and ensemble methods can be surprisingly good at this stuff. I'd honestly just start with adjusting class weights first since it's super easy to code up, then see how your precision/recall looks.
Honestly, just go with ReLU - it's the safe choice that actually works. I wasted so much time overthinking this on my first project lol. The thing is, sigmoid and tanh sound fancy but they'll kill your gradients in deeper networks. ReLU keeps things flowing so your early layers don't get stuck with tiny updates. Dead neurons bugging you? Try Leaky ReLU or ELU, but that's usually overkill. Don't get cute with exotic functions unless ReLU is clearly failing you. Trust me, vanilla ReLU handles like 90% of cases perfectly fine.
So batch size is just how many samples your model looks at before updating its weights. Small batches = noisy updates but they happen more often. Big batches are smoother but eat up way more memory (plus they can get trapped in weird spots sometimes). Most people stick with powers of 2 - like 32, 64, 128. Honestly, I'd just start with 32 and mess around from there. Watch your training speed and see if it's actually learning properly. Your hardware will probably dictate a lot of this anyway.
Honestly, transfer learning is a game changer - you basically grab a pre-trained model that's already learned stuff on huge datasets, then just fine-tune it for your specific problem. Way faster than starting from zero. The model already knows basic patterns like edges and shapes, so you're not teaching it everything from scratch. Perfect when your data is limited (which... yeah, happens a lot). You can either freeze those early layers and just retrain the last few, or fine-tune everything with a really low learning rate. Saves so much time and usually works better too.
Honestly, the biggest pain points are vanishing/exploding gradients and overfitting. Deep networks either kill your gradients completely or they blow up - both mess with training. Your model will also memorize the training data instead of actually learning patterns, which is annoying. Local minima are another headache where you get stuck in okay solutions instead of great ones. Hyperparameter tuning is basically just suffering through endless experiments until something works. Weight initialization helps a ton, and dropout or batch normalization can save you. Always test on fresh data though - that's how you'll catch problems early.
Oh definitely normalize your data! Your network will thank you for it. Without normalization, features with bigger numbers basically bully the smaller ones during training. Like if you're comparing salaries vs age - the salary numbers are way bigger so the model thinks they're more important. I usually go with z-score normalization but min-max works too. The tricky part is making sure you use the same scaling on your test data as your training data. Otherwise you're kinda cheating. Your gradients flow way better with normalized data and training actually converges instead of getting stuck in weird spots.
Depends what you're building, honestly. Classification? Go with accuracy, precision, recall, F1-score. Regression needs MSE, RMSE, MAE. I'm weird about checking loss curves constantly - they'll show if you're overfitting way before anything else does. Training metrics lie though. Your validation and test performance is what actually matters. Oh, and if your data's imbalanced, accuracy becomes totally useless. Stick with precision/recall or AUC-ROC instead. Plot everything over epochs and use multiple metrics together - gives you the real story of what's happening.
So basically regularization stops your model from just memorizing training data instead of actually learning patterns. It's like studying for a test - you want to understand the concepts, not memorize every single practice question, you know? Dropout and L2 regularization add constraints that force the model to learn more general stuff. Try dropout first (like 0.2-0.5 rate) - it's super easy to implement and usually helps right away. L2 is solid too. Both punish overly complex models that get too obsessed with fitting training examples perfectly, which honestly makes them way better on new data.
So basically, supervised learning is when you show the algorithm examples with the "right answers" - like photos labeled "cat" or "dog." It learns from those. Unsupervised is way messier because you just dump raw data on it and hope it finds patterns. No labels, no guidance. It might group similar customers together or spot weird outliers. Supervised works great when you know what you're looking for. Unsupervised is better for discovering stuff you didn't even know was there - though honestly it can be a pain to interpret sometimes.
So hyperparameter tuning is basically finding that sweet spot where your model learns at just the right pace - not too fast, not too slow. Honestly, it's one of those things that seems tedious but saves you tons of time later. Your learning rate and batch size? Start there, they'll give you the most noticeable improvements. Without decent tuning, you'll just sit there watching your loss function do weird bouncy things for hours (been there). Think of it like adjusting a recipe - small tweaks make everything work way better. The whole thing really does cut down training time once you get it dialed in.
Honestly, adaptive optimizers changed everything. Adam's probably your best bet to start with - it handles momentum and adjusts learning rates automatically, so you're not constantly tweaking that one annoying hyperparameter. Before Adam and stuff like RMSprop came around, people would waste so much time on manual tuning. Training's way more stable now and converges faster too. There's also AdamW if you run into weight decay problems later. I'd say just go with Adam first since it works well right out of the box, then maybe experiment if you need better performance. Works for like 90% of cases anyway.
-
I was able to find the right choice of PPT template for my thesis with SlideTeam. Thank you for existing.
-
The website is jam-packed with fantastic and creative templates for a variety of business concepts. They are easy to use and customize.